
查看 Token 用量
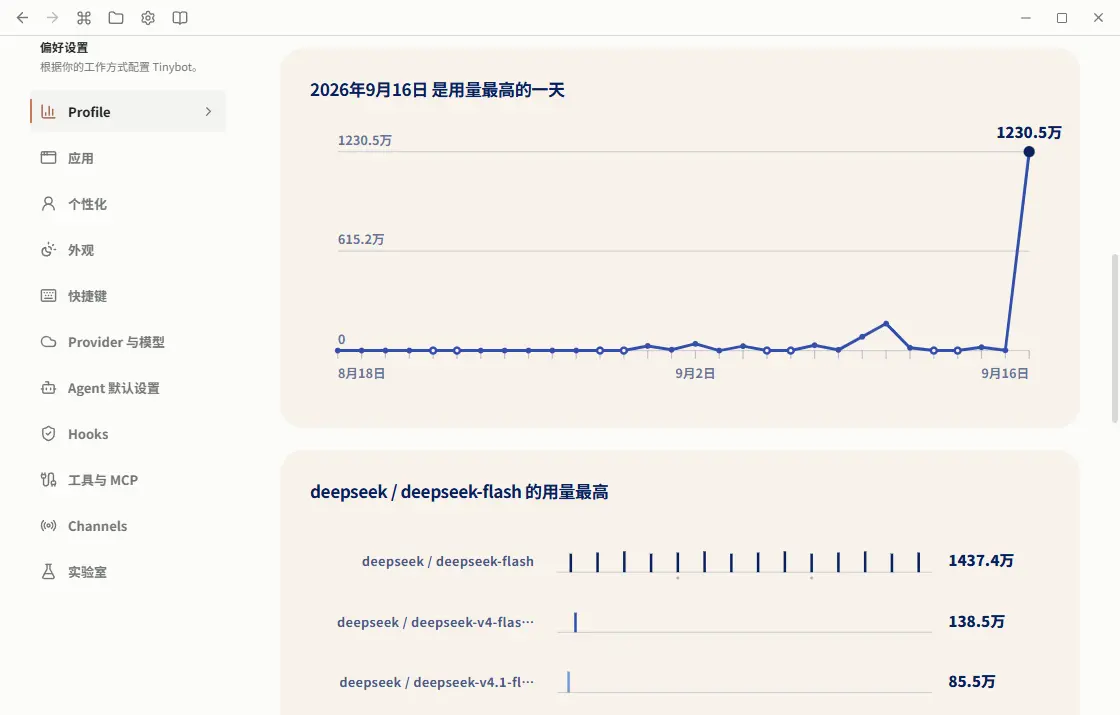
打开 设置 → Profile 查看这台设备记录的模型用量。这里的数字来自模型服务报告,不是账户余额或费用账单,也不会汇总你在其他应用、设备上的调用。
查看总览、趋势和模型
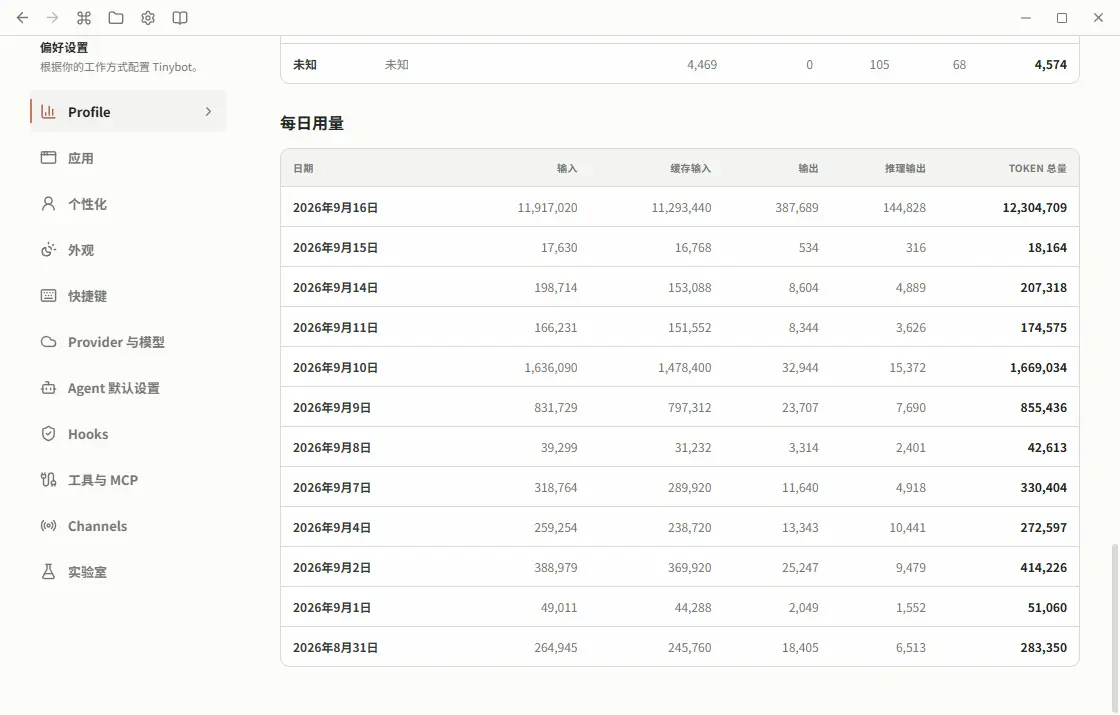
使用 Provider 与模型筛选查看对应用量,向下查看最近 30 天趋势、模型排名以及每日明细。不同模型的 Token 数量可以比较调用规模,但不能直接换算成相同费用。
正确理解各列
| 指标 | 含义 |
|---|---|
| 输入 | 提供给模型的输入 Token |
| 缓存输入 | 输入中由服务报告命中缓存的部分 |
| 未缓存输入 | 输入减去缓存输入 |
| 输出 | 模型返回的输出 Token |
| 推理输出 | 输出中由服务报告的推理部分 |
| Token 总量 | 服务报告的总量;未单独报告总量时由输入与输出计算 |
缓存输入已包含在输入中,推理输出已包含在输出中。不要把所有列再次相加。 例如输入 1,000、其中缓存 800,输出 200、其中推理 50,总量通常为 1,200,而不是 2,050。
按用途和请求追踪
按用途统计 区分普通对话、Team 规划与执行、子代理、自动化、上下文压缩、标题生成、记忆提取与整理,以及 Graph 路由与执行。一次用户任务可能包含多次模型请求,并产生多种用途的消耗。
请求明细 按开始时间倒序展示,每页最多 100 次,可点击 更早的请求 翻页,展开 来源详情 查看可用的会话、轮次、团队与任务归属。
真正发起另一次请求的重试有独立尝试记录。失败、取消或中断也会留下状态;“进行中 / 结果不确定”不一定表示现在仍在执行,例如应用异常退出可能留下未确认结果的记录。
查看某个 Team 的消耗
打开团队运行详情的 用量 页签,查看任务和用途分类。规划调用与执行调用会分开列出,可归属的后台工作也会保留来源。
24 应用截图 · 待补充
核对团队任务用量打开已完成团队运行的用量页签,展示规划、执行的用途行和任务分组,以及缓存、未缓存输入与推理列。
teams-usage.webp跨多个来源整理的共享记忆工作不会强行分摊给某个 Team。因此某个团队的数字不一定等于同一时段的全局消耗。
“不可用”、零和历史数据
- 不可用 / 未报告用量:没有拿到可用的整份计数,不能理解为没有消耗。网络中断、取消等情况也可能已产生服务端费用。
- 零:整份用量被识别后,当前实现会把缺失的单项字段按零展示。例如缓存或推理为零,不能据此确定服务确实报告了零。
- 历史未分类:旧版只保存汇总,没有足够信息还原用途、请求次数或 Team 归属。
当前没有独立拆分缓存写入、图片或音频用量,也不统计每段系统指令、工具定义和工具结果分别占多少 Token。需要金额核对时,以服务商账单为准;这个页面也不是阻止任务继续运行的预算设置。